

开源 · 自部署 · Apache 2.0
把分散的健康数据,变成有据可查的答案。
汇总化验单、穿戴设备和基因数据,统一名称与单位,让每个答案都有来源可查。通过 Docker 部署后,可选择云端模型,也可完全在本机运行。
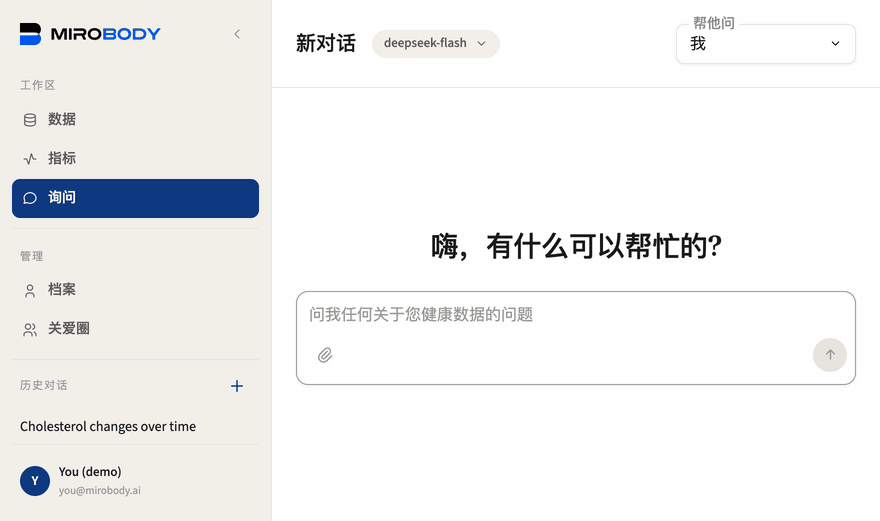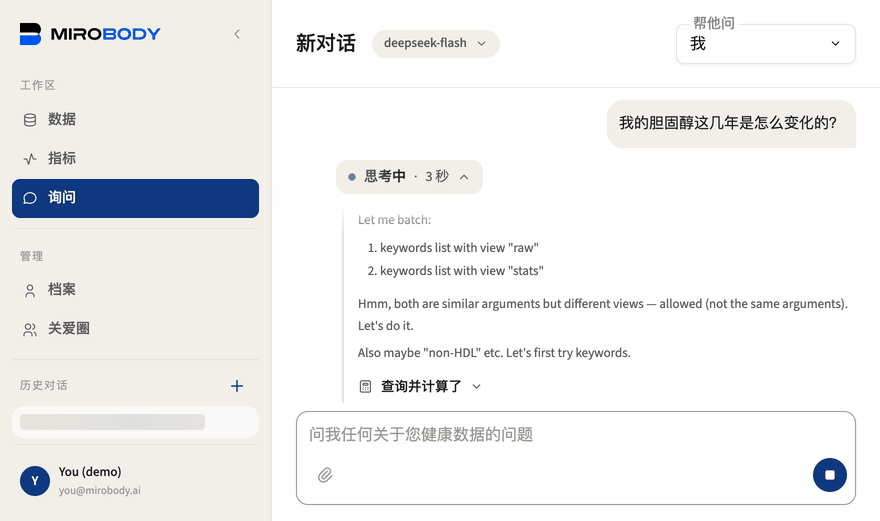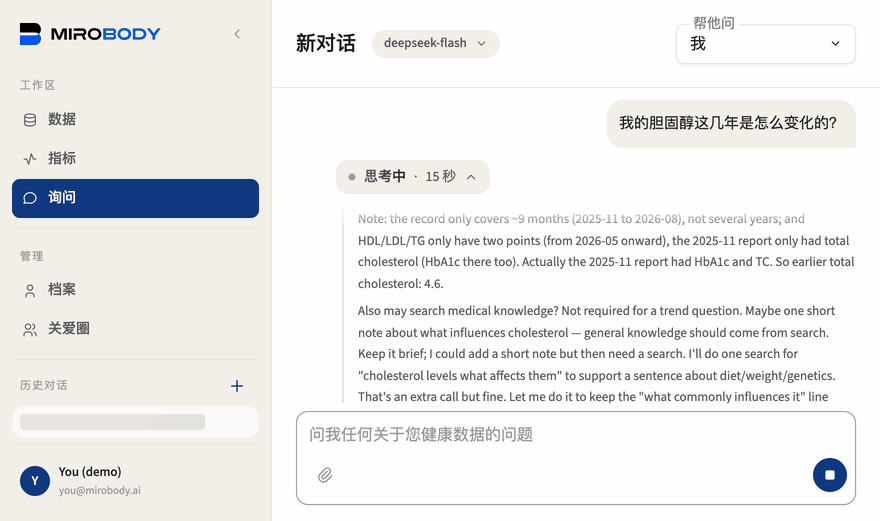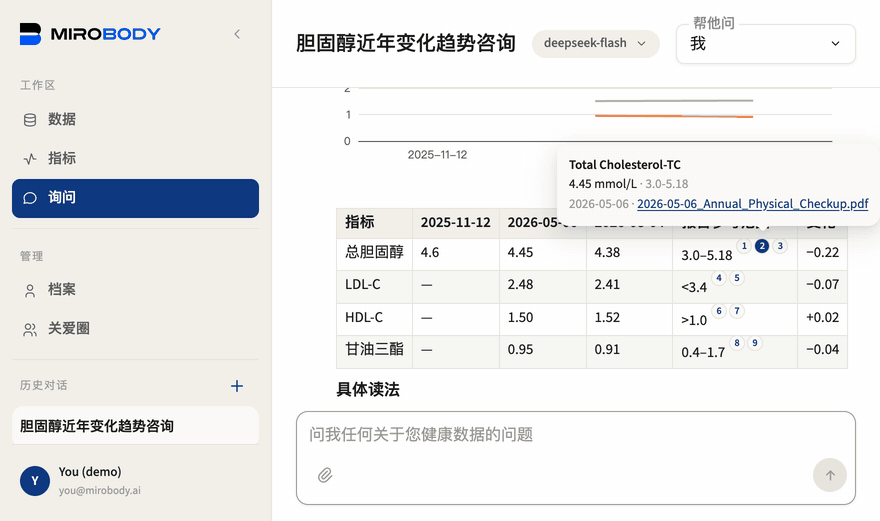
不同医院,不同写法。放进同一条趋势,回看每个数值的来源。
什么是 Mirobody?
Mirobody 是一个开源健康数据引擎。它将报告、设备数据、照片和基因文件整理为一份记录,对能够识别的项目统一名称与单位,再由 agent 根据记录回答问题,并提供原始来源。项目由 Theta Health 开发,采用 Apache 2.0 许可,也是 Theta Wellness 应用的基础引擎。

收集、转译、提问:从源文件到可追溯回答的三个阶段。
开始使用
用 Docker 运行
运行
./deploy.sh 启动 Web 应用和演示数据,再选择云端或本地模型。健康记录保存在你自己的 Postgres 数据库中。体验完整流程
上传、标准化、跨报告提问、与家人共享、记健康日记。
让所有模型留在本机
使用 llama.cpp 在本机运行模型,查看对应平台的配置方法和硬件要求。
接入你自己的 agent
通过 MCP 在 Claude Code、Codex、Cursor 或 Gemini CLI 中查询你的记录。
在 Python 中解析名称
安装
mirobody Python 包,离线解析 LOINC 编码与 UCUM 单位,无需模型密钥。在服务器上部署
生产设置、密钥、HTTPS、升级与备份。