

./deploy.sh、在 SEED_DEMO_DATA 打开时录制;
第 1 段是示意图,图示背后的授权规则列在图下方。
SEED_DEMO_DATA 默认打开,所以 ./deploy.sh 一结束,① → ② → ③ 这条链就能走通。
登录和浏览种子记录不需要模型;读取文件和回答问题,使用的是设置页里选定的模型:一把 Key,或本地模型。
1 · 进门。 你用 you@mirobody.ai 登录,看到的是两份记录,不是一份。
你自己的:一年的自测体征,加去年 11 月的一份化验单。
mom@mirobody.ai 的结构相同,但那是另一个人,以只读方式把记录共享给你,而她的体重在上升、睡眠偏短、HbA1c 已经超出范围。
同一个问题,两个答案,而两份记录里只有一份是你的。隔离是看得见的,不只是写在文档里。


这四条每一条都由测试作为安全属性固定下来。
这个开关是一个字段,不是一句承诺:
care_circle_members.health_access,NOT NULL DEFAULT 0,在你自己的那一行上。
被邀请进一个关爱圈本身不共享任何内容,由成员自己决定,别人的任何操作都无法提高它。
读取它的检查在拒绝时抛出异常,而不是返回一个假值,所以一条忘了检查的路由返回 403,而不是把记录交出去。
examples/06_care_circle_rules.py 能离线打印整张决策表。
只有一种成员例外:在「关爱圈」页面里添加的家人,比如不打算自己登录的父母。
TA 的邮箱是一个谁也无法登录的占位地址,所以这个开关由你代管,可读可写。
等 TA 想要自己的账号时,在 TA 的卡片上把邀请链接发给 TA。
TA 证明真实邮箱属于自己(向这个邮箱发送的验证码;部署不发邮件时则设置密码)后,这个账户和其中的全部数据就归 TA 所有,并由 TA 决定你还保留哪种权限:查看和编辑、仅查看,或者不再查看。
如果这个邮箱已经有账户,记录会合并进去。
2 · ① 收集。 demo/upload/ 里放着四份种子数据有意没有写入的文件,所以上传一份不是空操作。
它们是四种不同的格式,因为健康档案本来就以化验所、诊所和家里各自产出的样子到来:
把一份文件拖到「数据」页,文件先被原样保存,可以追溯。
① 收集只做这一件事,而这个切分很重要:化验所写了什么是一个事实,它代表什么是另一个。
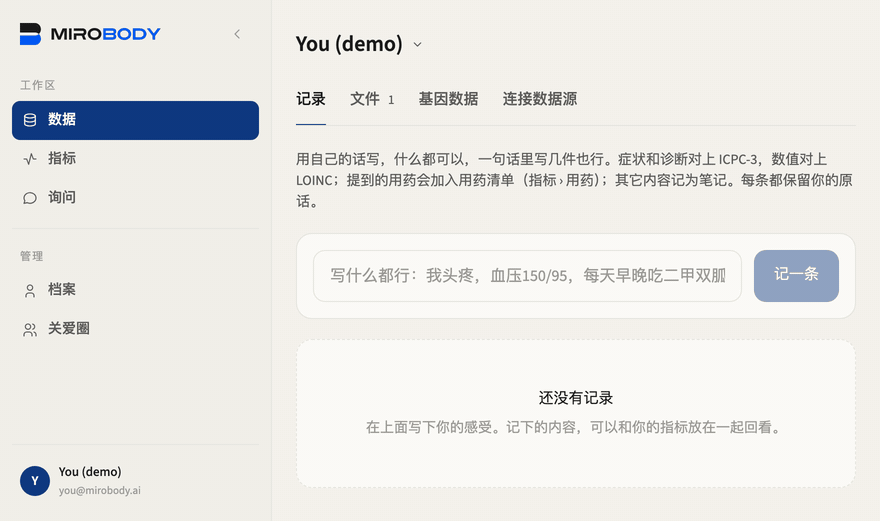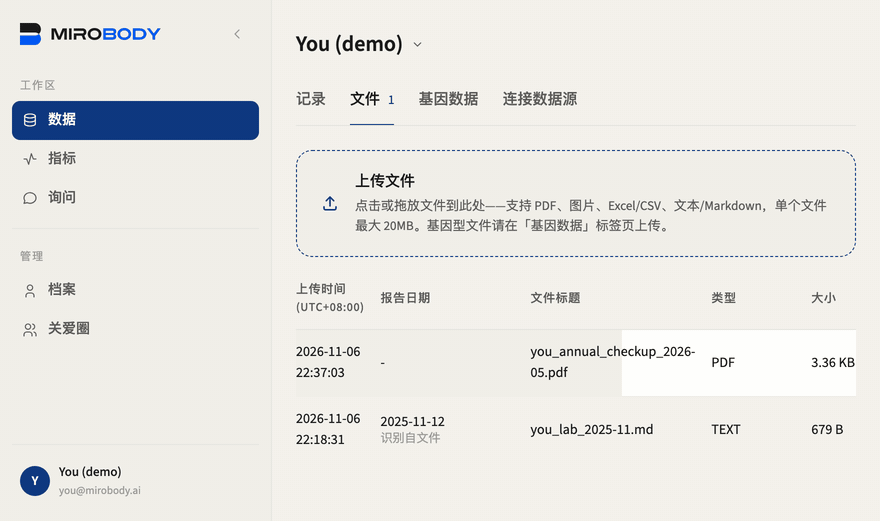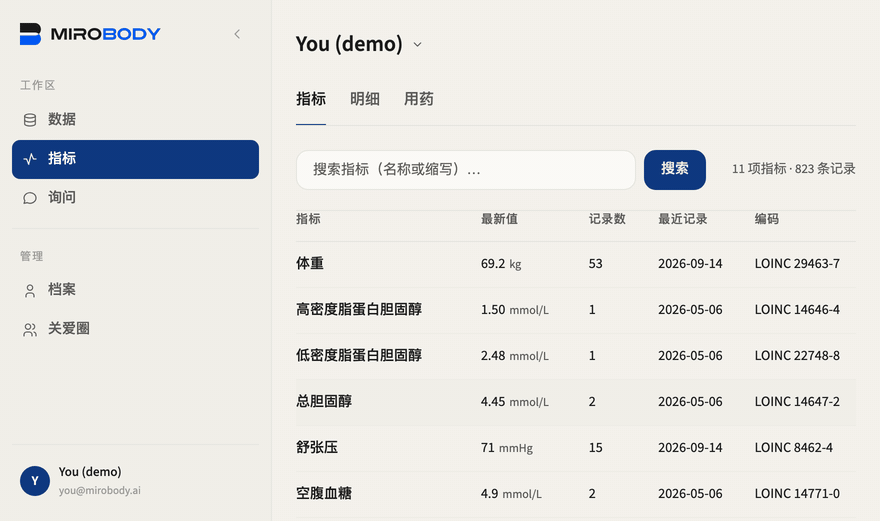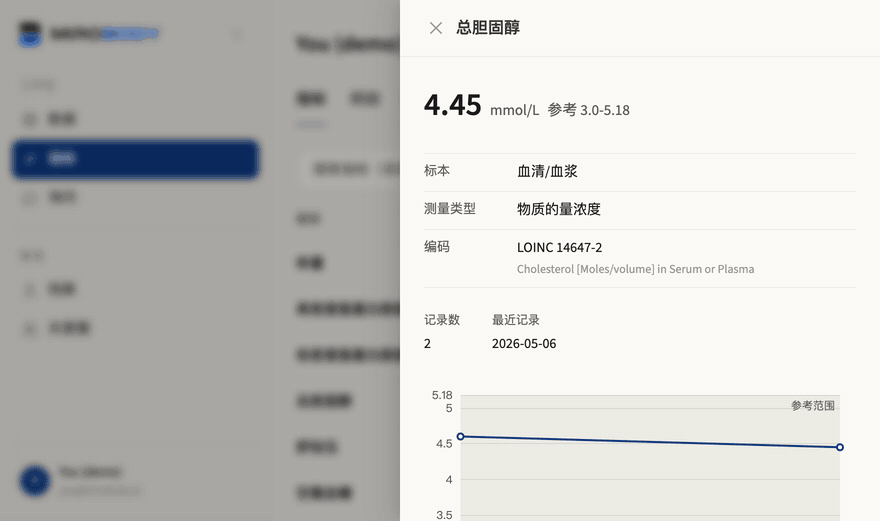
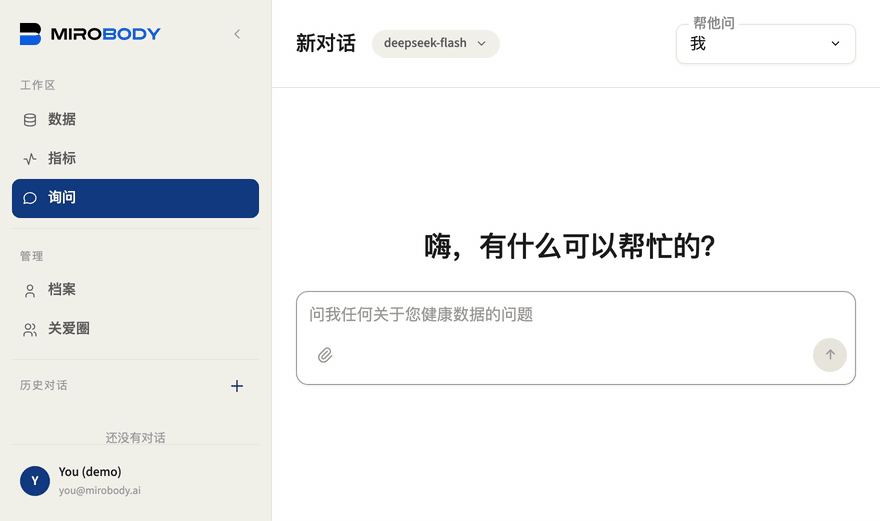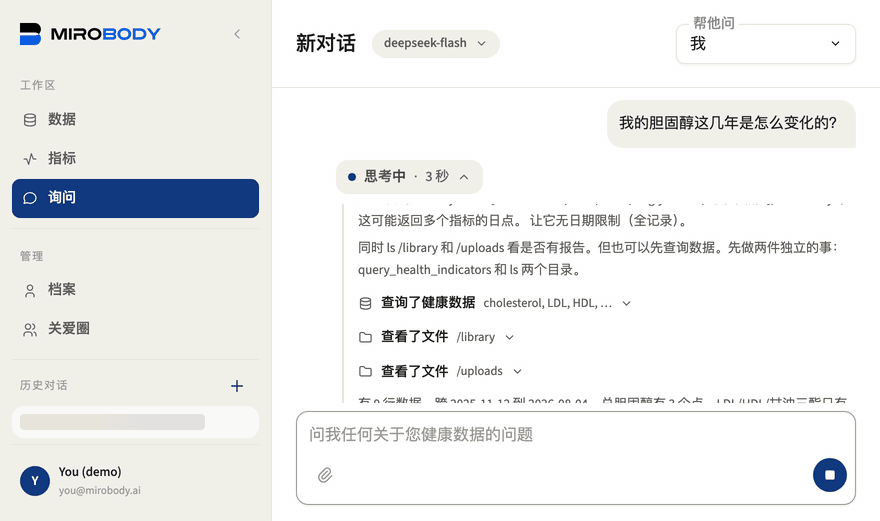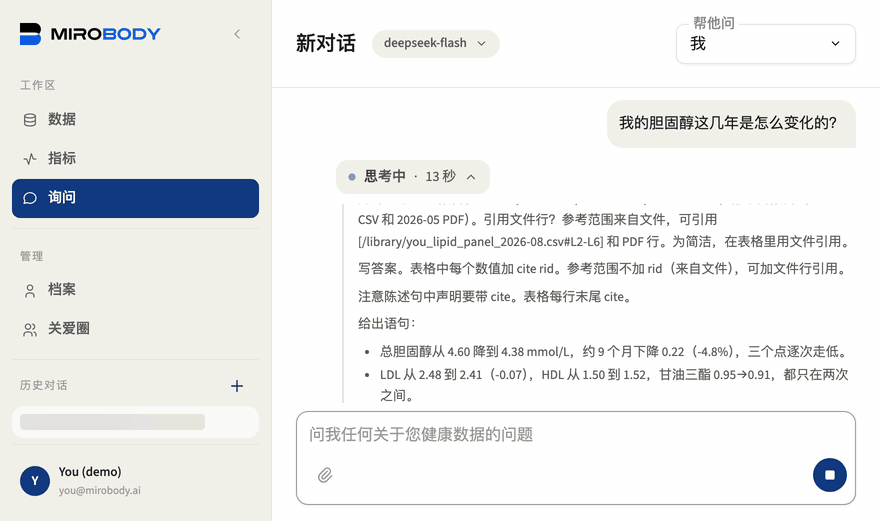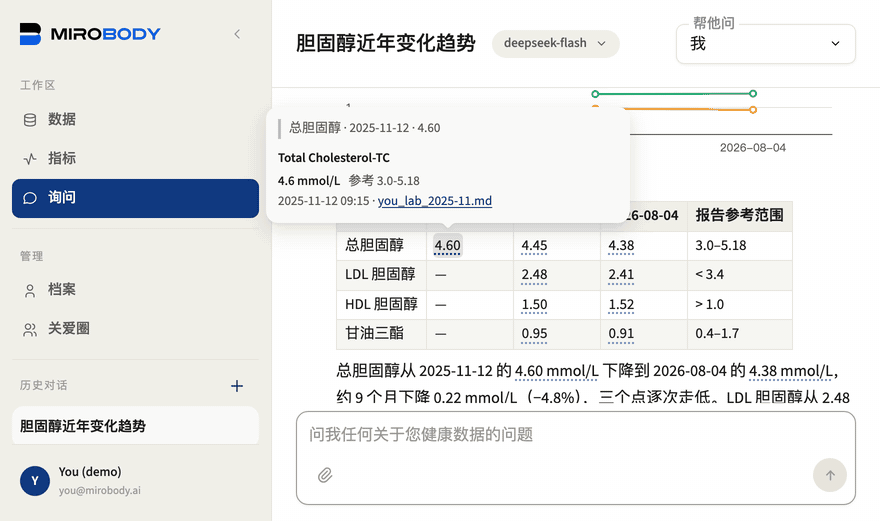
Total Cholesterol-TC,它写的是 Cholesterol, Total,而两者都是 14647-2,所以它们是一条序列,不是两条。
单位是这个身份的一部分,而不是被抹平的细节:胆固醇在 mmol/L 下是 14647-2,在 mg/dL 下是 2093-3。
把这一点说清楚,才能避免一条由两种单位混合而成的趋势悄悄出错。
把这两个编码归并成一条可比较的线,是 1.5.0 的 comparability key;
设备一侧的换算已经在做,examples/02_standardize_a_reading.py 能离线把 154.5 lb 换算成 70.08 kg。
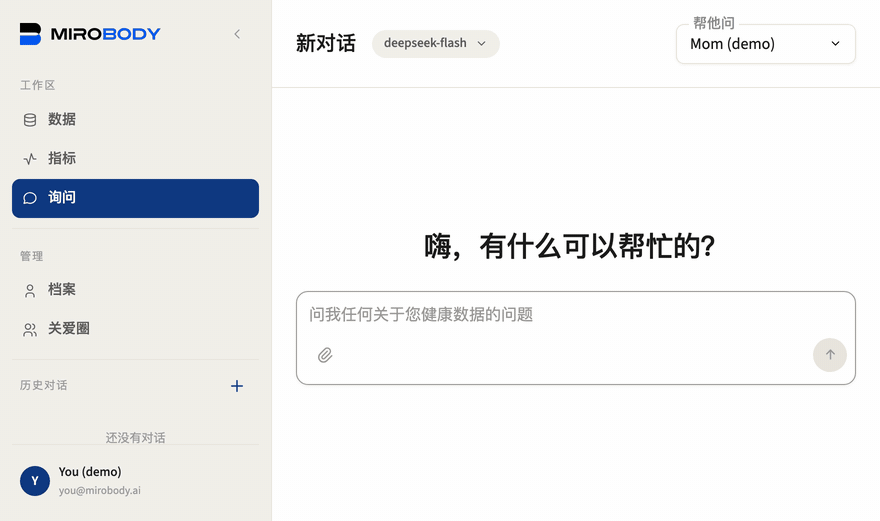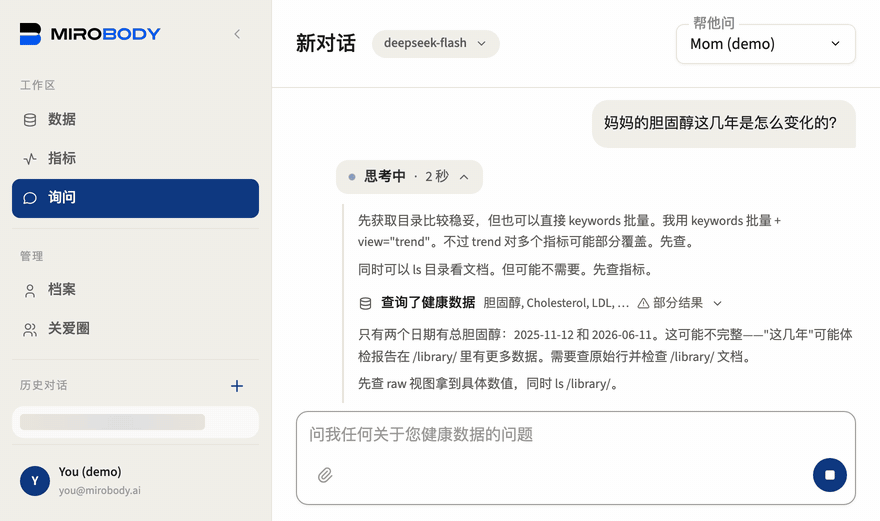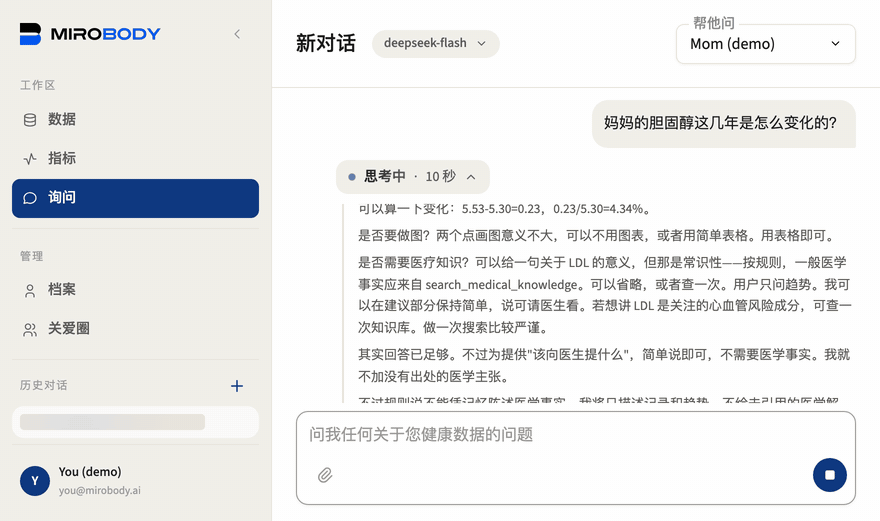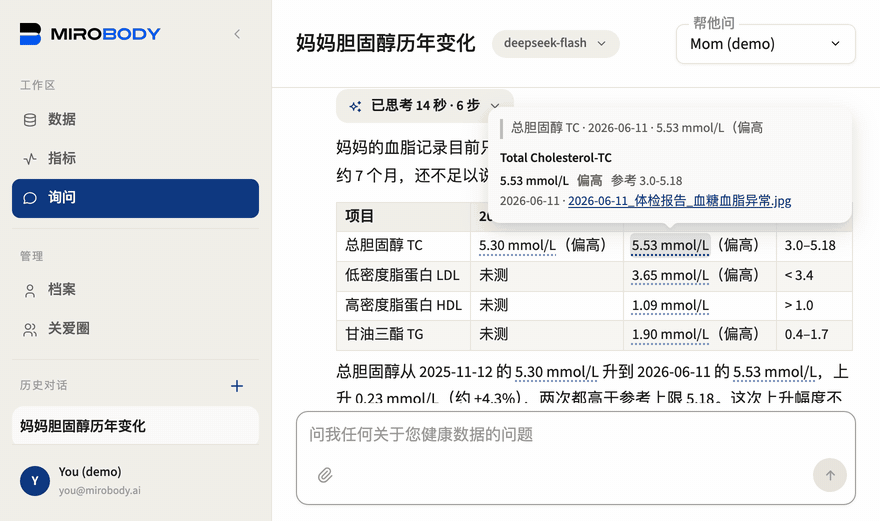
4 · ③ 智能体。 问一句胆固醇有什么变化。
回答过程中,每一步都会实时显示在思考旁边(「正在查询健康数据」「正在阅读文件」),答案开始后再收起来。
agent 会把带着这一项的文件全部找出来,包括 CSV 里不同的写法,然后根据它读到的内容作答:
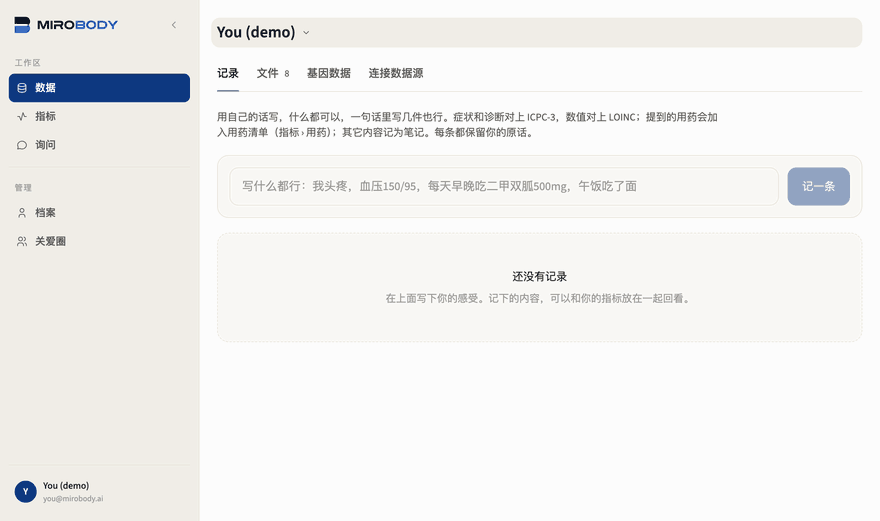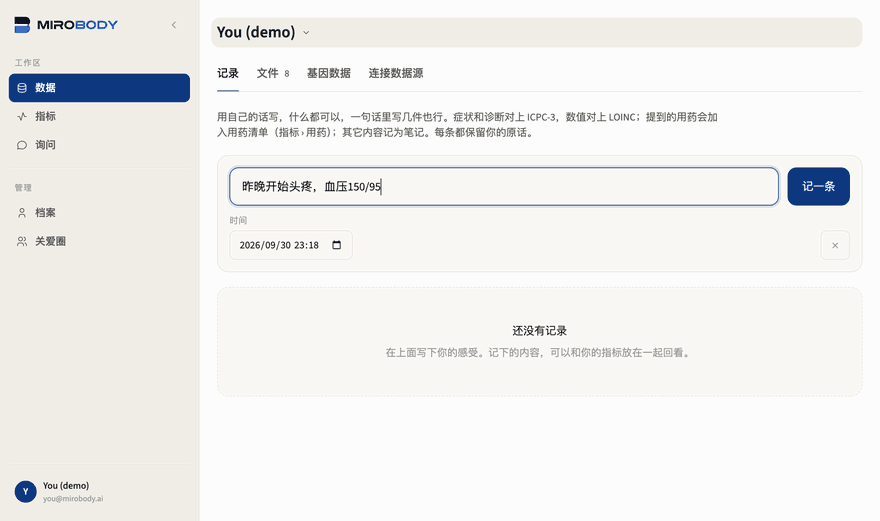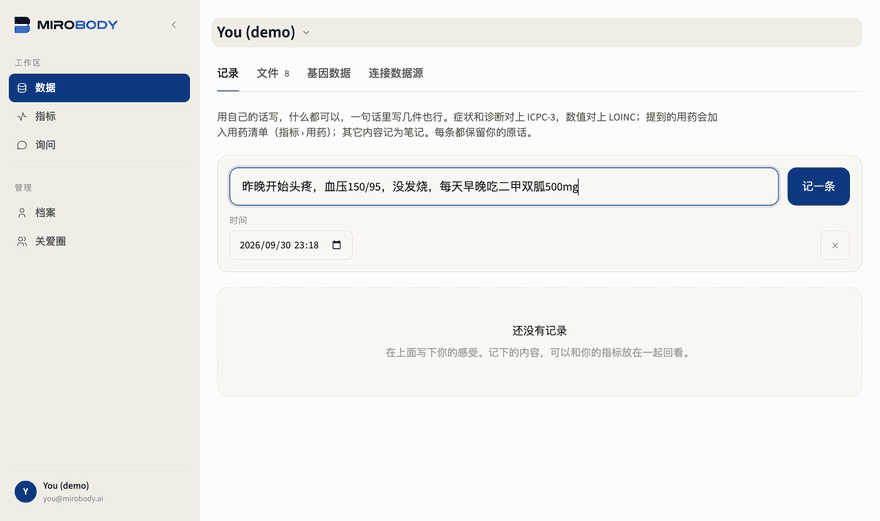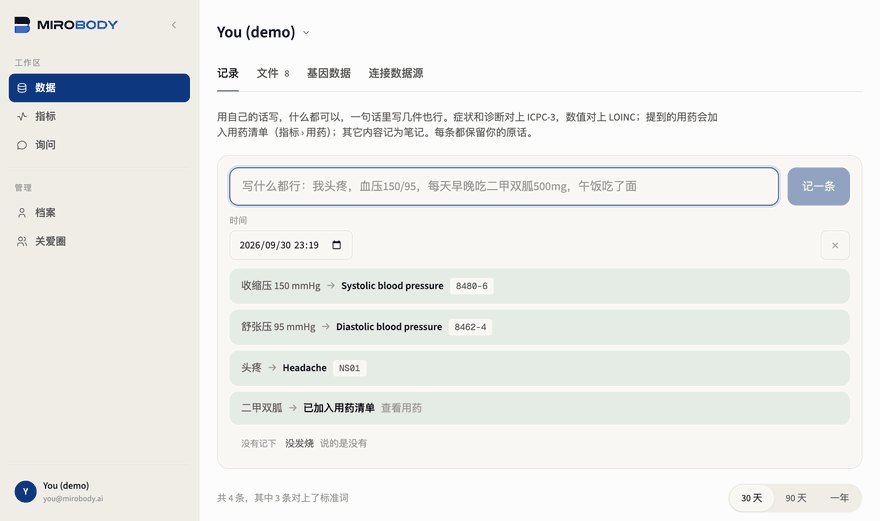
昨晚开始头疼,血压150/95,没发烧,每天早晚吃二甲双胍500mg。
模型负责拆句并给每一部分分类;编码来自词表。
这句话变成一条编码为 NS01 的头痛、编码为 8480-6 和 8462-4 的血压,以及用药清单里的二甲双胍。
「没发烧」不会被当成发烧记下来。
SEED_DEMO_DATA 设为 false。
demo/README.md 说明每份文件是什么、如何重建;
抽取这一步对这些指标尚未做到的事,写在 docs/roadmap.md 里,而不是在这里一笔带过。