

安装前也可以先打开 Mirobody 网页演示,查看合成健康档案和问答效果。
A · 使用 Python 库
安装 uv 后,执行: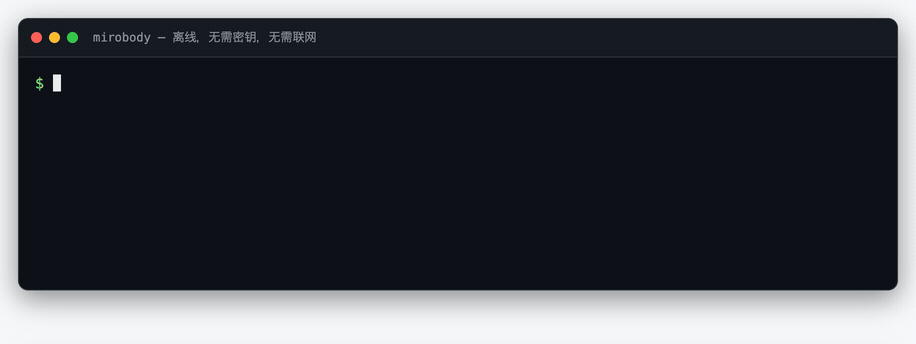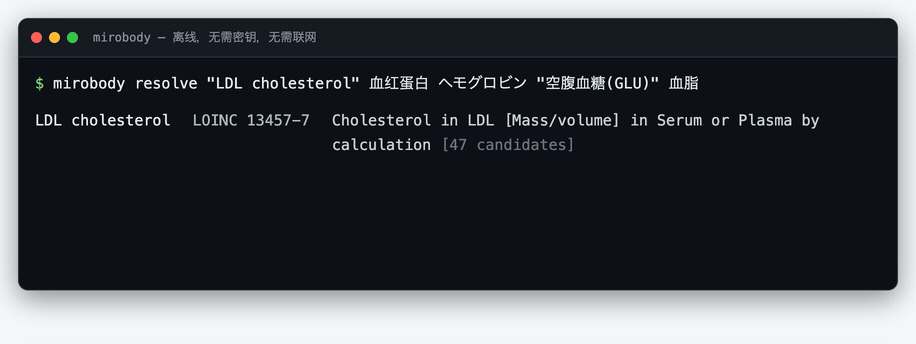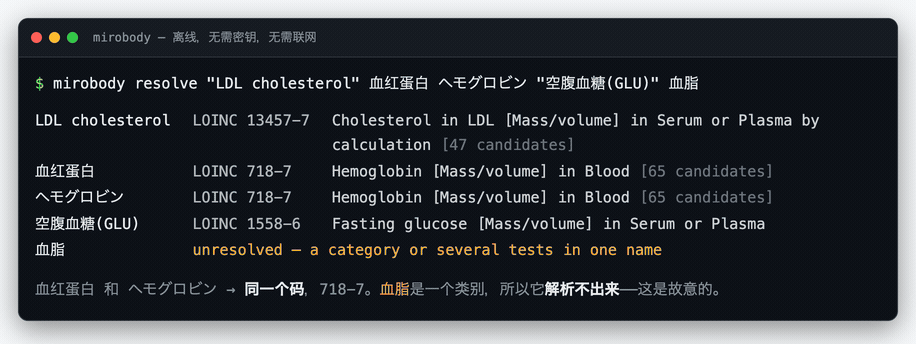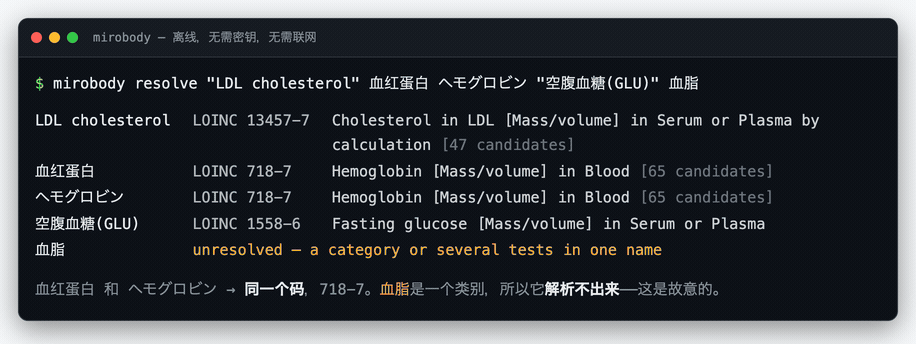
血红蛋白 和 ヘモグロビン 都会匹配 LOINC 718-7。血脂 是一类指标的统称,会保留为未解析,避免误用某项具体检验的编码。
在 Python 3.12+ 项目中,先安装:
pip install 'mirobody[parse]',并配置模型 API Key。
接入 MCP 客户端时,运行 uvx --python 3.12 mirobody mcp,即可通过 stdio 使用离线词表工具。文档工具 standardize_report 则需要 [parse] 扩展和模型 API Key。主诉与诊断编码、单位转换及 FHIR 输出的用法见 standardization.zh-CN.md,可执行示例见 examples/。
B · 部署完整应用
完整应用包含网页客户端、服务端、后台任务进程,以及支持 pgvector 的 Postgres。可以选择云端试用或本地部署。在 Codespaces 体验
 创建 Codespace,等待终端中的自动配置完成。打开终端输出的 HTTPS 设置链接,输入自己的模型 API Key,例如 OpenRouter 或 OpenAI。设置页会发送真实请求验证 Key。
18060 端口默认仅向自己转发。
应用和记录保存在 GitHub 云端,需要模型处理的文档和问题会发送给所选模型服务商。试用时请使用仓库提供的合成数据。费用分别按 Codespaces 计费规则 和模型服务商的收费规则计算。用完后停止 Codespace,下次打开会自动重新启动应用。
100% 在本机运行
安装 Git、OpenSSL 和 Docker Compose 后,执行:.env,自动选择本地模型,最后输出应用链接。预构建镜像已包含 LOINC 词表,因此 Docker 部署不需要 Git LFS。
如需使用云端模型, 直接执行 ./deploy.sh,不启用本地 profile。打开 http://localhost:18060 的设置链接,输入模型 API Key。记录保存在本机,需要模型处理的文档和问题发送给所选服务商。
登录并上传示例
在「邮箱验证码」标签使用you@mirobody.ai、验证码 111111 登录,无需配置邮件服务。可以先问「我的胆固醇有什么变化?」,再到「数据」页上传 demo/upload/ 中的合成文件。这些文件未预先导入,上传后可验证完整的文档处理流程。其中 you_lab_report_zh_2023-03.pdf、you_checkup_photo_zh_2024-04.jpg、you_lab_results_en_2025-03.xlsx 是三家机构、三个年份的合成化验单,同一项检查有三种写法、两种单位。三份都上传后,在「指标」里点开「低密度脂蛋白胆固醇」,可以看到它们连成一条趋势,每个数字都能点回原文件。
如需保存真实数据,请在首次启动前设置 SEED_DEMO_DATA=false。 否则应用会创建两个使用公开登录信息的示例账号。
也可以在 .env 中设置 OPENROUTER_API_KEY、OPENAI_API_KEY、GOOGLE_API_KEY 或 ANTHROPIC_API_KEY;使用 OpenAI 兼容网关时,通过 <PROVIDER>_BASE_URL 指定地址。config.llm.yaml 仅声明各条目读取的变量名,密钥应保存在环境变量中。修改 .env 后执行 docker compose up -d,restart 不会重新加载配置。
检查当前模型配置,并向各模型发送测试请求:
C · 从源码开发
version。在仓库根目录运行 dev,即可同时访问 frontend/ 中的网页客户端和 API;Python 安装包本身不包含网页客户端。
dev 默认生成临时密钥。如需重启后保留会话和加密配置,请设置固定的 JWT_KEY 和 CONFIG_ENCRYPTION_KEY。同时请设置 PG_ENCRYPTION_KEY 和 DATABASE_DECRYPTION_KEY:不设置时,数据库中加密存储的记录字段与设备凭据会使用随包附带的占位密钥(见 SECURITY.md)。正式部署使用 serve,它读取随包配置和 config.{ENV}.yaml,并要求使用持久化密钥。
Debian 或 Ubuntu 也可直接运行 scripts/install_native.sh,安装 PostgreSQL、pgvector 和 Python 环境,无需 Docker;然后通过 scripts/start_native.sh 启动 worker 和端口 18060 上的服务端。